GPT-5 vs Claude 4 im Jahr 2026: Das ultimative KI-Duell
GPT-5 vs Claude 4 – die beiden leistungsstärksten KI-Modelle im direkten Vergleich. Wir testen Schreiben, Programmieren, Schlussfolgern, multimodale Aufgaben und mehr, um herauszufinden, welches Flaggschiff-KI-Modell 2026 gewinnt.
1X2.TV — KI-Fußballprognosen
KI-gestützte Vorhersagen für Fußballspiele, Wett-Tipps und tiefgehende Analysen. Ermöglicht durch Machine-Learning-Algorithmen, die über 50.000 Spiele analysieren.
Vorhersagen abrufenZwei KI-Labore. Zwei Flaggschiff-Modelle. Eine Frage: Welches ist besser?
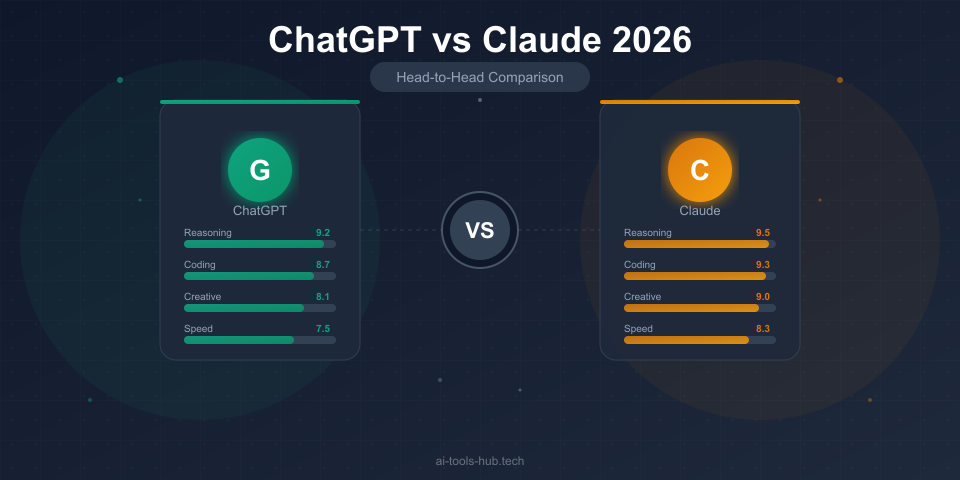
OpenAIs GPT-5 und Anthropics Claude 4 repräsentieren den aktuellen Stand der Technik bei großen Sprachmodellen. Beide sind außergewöhnlich leistungsfähig, beide kosten 20 USD/Monat für den privaten Zugang, und beide haben behauptet, menschliche Leistungen bei wichtigen Benchmarks zu übertreffen. Im täglichen Einsatz fühlen sie sich jedoch deutlich unterschiedlich an.
Wir haben beide Modelle wochenlang bei Dutzenden von Aufgaben aus der Praxis getestet. Hier ist unser Ergebnis.
Auf einen Blick
| Funktion | GPT-5 | Claude 4 (Opus) |
|---|---|---|
| Entwickler | OpenAI | Anthropic |
| Kontextfenster | 128K Tokens | 1M Tokens |
| Multimodal | Text, Bild, Audio, Video | Text, Bild |
| Sprachmodus | Erweitert (Echtzeit) | Eingeschränkt |
| Websuche | Ja | Ja |
| Bildgenerierung | Ja (DALL-E-Integration) | Nein |
| Code-Interpreter | Ja | Ja |
| API-Zugriff | Ja | Ja |
| Preis für Privatnutzer | 20 USD/Monat (Plus) | 20 USD/Monat (Pro) |
| API-Preis (Eingabe) | ~10 USD/M Tokens | ~15 USD/M Tokens |
| API-Preis (Ausgabe) | ~30 USD/M Tokens | ~75 USD/M Tokens |
Schreibqualität
Hier wird der Vergleich am interessantesten – und am subjektivsten.
GPT-5 schreibt mit bemerkenswerter Flüssigkeit und Vielseitigkeit. Es passt seinen Ton effizient an, meistert ungewöhnliche Formate gut und ist besonders stark bei strukturierten Inhalten wie Berichten, Angeboten und Marketingtexten. Es neigt zu einer selbstbewussten, klaren Stimme.
Claude 4 schreibt mit dem, was wir als mehr Nuance bezeichnen würden. Es erfasst die feinen emotionalen Schattierungen natürlicher, vermeidet die leicht mechanische Qualität, die in GPT-5-Ausgaben auftreten kann, und glänzt bei Langtexten, die über Tausende von Wörtern hinweg eine konsistente Stimme beibehalten müssen. Für Romane, persönliche Essays und Inhalte, die eine menschliche Note erfordern, lieferte Claude 4 durchweg ausgearbeitetere Ergebnisse, die weniger Nachbearbeitung benötigten.
Sieger: Claude 4 für Langtexte und nuanciertes Schreiben; GPT-5 für strukturierte Geschäftsinhalte und schnelle Iterationen.
Testbeispiel: Produktbeschreibung
Wir baten beide Modelle, eine überzeugende Produktbeschreibung für Premium-Kopfhörer mit Geräuschunterdrückung zu verfassen, die sich an kreative Fachleute richtet.
GPT-5 lieferte saubere, nutzenorientierte Texte mit starken Einstiegshooks. Professionell und effektiv.
Claude 4 lieferte Texte, die stimmungsvoller wirkten – es fing die emotionale Erfahrung von Konzentration und Flow so ein, dass es weniger wie Marketing und mehr wie Storytelling wirkte.
Programmierung
Beide Modelle sind herausragende Coder. Der Abstand hat sich gegenüber vor noch 12 Monaten deutlich verringert.
GPT-5 liegt bei der Breite vorn: Es verarbeitet exotische Sprachen und Legacy-Frameworks zuverlässiger, hat ein besseres Gedächtnis für spezifische Bibliotheks-APIs und erzeugt über verschiedene Aufgaben hinweg häufiger direkt funktionierenden Code im ersten Entwurf.
Claude 4 ist die Wahl für Codeverständnis und Review. Geben Sie ihm eine 10.000-Zeilen-Codebasis und bitten Sie es, die Architektur zu erklären, den Fehler zu finden oder ein Modul zu refactorn – es geht mit dem gesamten Kontextfenster eleganter um. Seine Erklärungen zu komplexem Code sind klarer und leichter nachvollziehbar.
Gewinner: GPT-5 für die Generierung über verschiedene Stacks hinweg; Claude 4 für Code-Review, Erklärungen und Aufgaben mit großen Codebasen.
Benchmark-Ergebnisse
| Benchmark | GPT-5 | Claude 4 Opus |
|---|---|---|
| HumanEval (Python) | 92.3% | 90.1% |
| SWE-bench Verified | 49.2% | 72.5% |
| MBPP (Code-Aufgaben) | 88.4% | 86.9% |
Das SWE-bench-Ergebnis ist bemerkenswert: Claude 4 übertrifft GPT-5 bei realen Software-Engineering-Aufgaben, die das Verständnis und die Änderung bestehender Codebasen erfordern, deutlich – was das Muster bestätigt, das wir im Test gesehen haben.
Reasoning und Problemlösung
Beide Modelle bieten erweiterte Thinking-/Reasoning-Modi, die es ihnen ermöglichen, vor der Antwort auf komplexe Fragen „laut zu denken“.
GPT-5 mit aktiviertem Reasoning ist außergewöhnlich gut bei mathematischer Problemlösung, formaler Logik und strukturierten analytischen Aufgaben. Es geht Probleme systematisch an und macht bei klar definierten Problemen selten Flüchtigkeitsfehler.
Claude 4 zeigt im erweiterten Thinking-Modus seine Stärke bei mehrdeutigen, realen Problemen, bei denen die Frage selbst zerlegt werden muss. Es erkennt besser, wenn eine Frage versteckte Annahmen enthält, bietet mehrere Perspektiven und kann mit Unsicherheit umgehen. Bei strategischen Entscheidungen, Policy-Analysen und allen Problemen ohne klare Antwort wirkt Claude 4 intellektuell ehrlicher.
Gewinner: GPT-5 für reine Mathematik und formale Logik; Claude 4 für komplexes, mehrdeutiges Reasoning in der realen Welt.
Multimodale Fähigkeiten
Dies ist der Bereich, in dem GPT-5 den deutlichsten Vorteil hat.
GPT-5 kann Text, Bilder, Audio und Video verarbeiten – und der Sprachmodus ist wirklich beeindruckend. Sie können ein natürliches, latenzarmes Sprachgespräch mit Echtzeit-Unterbrechungen führen. Das Modell kann analysieren, was es über Ihre Kamera „sieht“, Dokumente lesen und Bilder detailliert beschreiben. Die integrierte DALL-E-Bildgenerierung ermöglicht es Ihnen, von der Idee zum Bild zu gelangen, ohne das Tool zu wechseln.
Claude 4 verarbeitet nur Text und Bilder. Die Bildanalyse ist hervorragend – detailliert, nuanciert und besser als bei GPT-5 beim Verständnis komplexer Diagramme, Grafiken und technischer Zeichnungen. Aber es kann weder Audio noch Video verarbeiten, bietet keinen nennenswerten Sprachmodus und kann überhaupt keine Bilder generieren.
Sieger: GPT-5 – es ist kein knappes Ergebnis, wenn Sie multimodale Fähigkeiten über die Bilderkennung hinaus benötigen.
Leistung bei langen Kontexten
1 Million Token Kontextfenster bei Claude 4 (im Vergleich zu 128K bei GPT-5) ist ein echter Wettbewerbsvorteil für bestimmte Anwendungsfälle:
- Den gesamten Codebase auf einmal analysieren
- Zusammenfassung eines Buches
- Durchführung komplexer, dokumentübergreifender Recherche-Synthesen
- Kohärenz über sehr lange Konversationen hinweg bewahren
In unseren Tests machte Claude 4 deutlich weniger Fehler, wenn es darum ging, Informationen aus verschiedenen Teilen eines langen Dokuments zu verknüpfen. Die Leistung von GPT-5 verschlechterte sich gegen Ende des Kontextfensters spürbar – eine bekannte Einschränkung, die es mit den meisten auf Transformer basierenden Modellen teilt.
Sieger: Claude 4 — mit großem Vorsprung bei Aufgaben, die einen sehr langen Kontext erfordern.
Befolgung von Anweisungen
Beide Modelle sind hervorragend darin, detaillierte, komplexe Anweisungen zu befolgen. Aber sie scheitern auf unterschiedliche Weise.
GPT-5 neigt dazu, Anweisungen überzuinterpretieren – es fügt möglicherweise hilfreiche Extras hinzu, die Sie nicht angefordert haben, geht über den Umfang Ihrer Anfrage hinaus oder ändert das von Ihnen angegebene Format subtil. Das kann nützlich sein (es liefert Vorschläge, an die Sie selbst nicht gedacht hätten), aber auch frustrierend, wenn Sie eine präzise Ausgabe benötigen.
Claude 4 befolgt Anweisungen wörtlicher und weicht seltener vom Skript ab. Wenn Sie eine exakte Einhaltung von Format, Wortanzahl oder Struktur benötigen, ist Claude 4 zuverlässiger. Es lehnt zudem vernünftige Anfragen seltener ab und fügt weniger unnötige Einschränkungen hinzu.
Sieger: Claude 4 für Präzision; GPT-5 für proaktive Hilfestellung.
Sicherheit und Ehrlichkeit
Anthropics Mission ist die Sicherheit von KI, und das zeigt sich im Verhalten von Claude 4.
Claude 4 ist offener im Umgang mit Unsicherheit, sagt eher „Ich weiß es nicht“, wenn es nicht weiß, und ist eher bereit, bei problematischen Prompts gegenzusteuern. Es neigt auch weniger dazu, selbstbewusst zu halluzinieren – wenn es sich Dinge ausdenkt (und das tut es), schränkt es diese oft so ein, dass die Unsicherheit deutlich wird.
GPT-5 kann etwas selbstbewusster sein, als es die Fakten rechtfertigen. Die Halluzinationsrate hat sich drastisch verbessert, aber es stellt gelegentlich noch Erfindungen im selben Tonfall wie gesicherte Fakten dar.
Beide Modelle lehnen eindeutig schädliche Anfragen ab. Claude 4 kann bei grenzwertigen Themen etwas übertrieben vorsichtig sein; GPT-5 ist etwas nachsichtiger.
Sieger: Claude 4 bei Ehrlichkeit und kalibrierter Unsicherheit; das muss nicht für alle Anwendungsfälle relevant sein.
Preisvergleich
Verbraucher-Tarife
- ChatGPT Plus (Zugang zu GPT-5): 20 USD/Monat
- Claude Pro (Zugang zu Claude 4 Sonnet + Opus): 20 USD/Monat
Für 20 USD/Monat bieten beide einen vergleichbaren Wert. GPT-5 über ChatGPT Plus umfasst Zugang zur DALL-E-Bildgenerierung, zum Sprachmodus und zu Speicherfunktionen. Der Hauptvorteil von Claude Pro sind höhere Nutzungslimits beim leistungsstärkeren Opus-Modell.
API-Preise (pro Million Tokens)
| Modell | Eingabe | Ausgabe |
|---|---|---|
| GPT-5 | ~$10 | ~$30 |
| Claude 4 Opus | ~$15 | ~$75 |
| Claude 4 Sonnet | ~$3 | ~$15 |
| GPT-4o | ~$5 | ~$15 |
GPT-5 ist über die API deutlich günstiger. Bei Anwendungen mit hohem Datendurchsatz ist das enorm wichtig. Claude 4 Sonnet (das Mittelklasse-Modell) ist preislich konkurrenzfähig und liefert bei den meisten Aufgaben hervorragende Ergebnisse – viele Entwickler halten es für das bessere Preis-Leistungs-Verhältnis als beide Flaggschiffe.
Sieger: GPT-5 bei den API-Kosten im großen Maßstab.
Ökosystem und Integrationen
GPT-5 profitiert vom großen Vorsprung von OpenAI bei der Ökosystementwicklung. ChatGPT-Plugins, der GPT Store, umfangreiche Unternehmenspartnerschaften und der Status der OpenAI API als Standard-Integrationsziel für die meisten SaaS-Tools verschaffen ihm einen erheblichen praktischen Vorteil.
Claude 4 über die Anthropic API holt schnell auf. Wichtige Enterprise-Tools wie Salesforce, Notion und Slack bieten inzwischen Claude-Integrationen an. Die Claude API ist auch die Standardwahl für viele Start-ups, die sicherheitskritische Anwendungen entwickeln. Claude Code – der terminalbasierte Coding-Assistent von Anthropic – ist bei Entwicklern zunehmend beliebt.
Sieger: GPT-5 bei der Breite des Ökosystems; die Lücke schließt sich.
Direktvergleich: Zusammenfassung
| Aufgabe | Sieger |
|---|---|
| Langtext-Schreiben | Claude 4 |
| Geschäftliche/strukturierte Texte | GPT-5 |
| Codegenerierung | GPT-5 (leichter Vorteil) |
| Code-Review & große Codebasen | Claude 4 |
| Mathematik & formales Denken | GPT-5 |
| Komplexes Denken in realen Szenarien | Claude 4 |
| Bild-, Audio- und Videobearbeitung | GPT-5 |
| Analyse langer Dokumente | Claude 4 |
| Sprachinteraktion | GPT-5 |
| Bildgenerierung | GPT-5 |
| Befolgung von Anweisungen (Präzision) | Claude 4 |
| Ehrlichkeit & Kalibrierung | Claude 4 |
| API-Preise | GPT-5 |
| Kontextfenster | Claude 4 |
Wer sollte welches Tool nutzen
Wählen Sie GPT-5, wenn Sie:
- Sprachmodus oder multimodale Fähigkeiten (Audio, Video) benötigen
- Integrierte Bildgenerierung wünschen
- Hochvolumige API-Anwendungen entwickeln, bei denen die Kosten eine Rolle spielen
- Das breiteste Ökosystem an Integrationen benötigen
- Stark mit Codegenerierung über verschiedene Programmiersprachen hinweg arbeiten
- Ein Modell bevorzugen, das über den strikten Prompt hinaus proaktiv Mehrwert bietet
Wählen Sie Claude 4, wenn Sie:
- Längere Texte schreiben und großen Wert auf Qualität legen
- Mit großen Dokumenten oder Codebasen arbeiten müssen
- Präzise Befolgung von Anweisungen und vorhersagbare Ausgaben benötigen
- Ehrlichkeit, Kalibrierung und intellektuelle Bescheidenheit schätzen
- Dokumente, Berichte oder Forschungsergebnisse eingehend analysieren
- Anwendungen entwickeln, bei denen Sicherheit und ein geringeres Halluzinationsrisiko wichtig sind
Nutzen Sie beide, wenn Sie:
- Sich nichts entgehen lassen können (die Modelle ergänzen sich tatsächlich gegenseitig)
- An ausreichend vielfältigen Aufgaben arbeiten, sodass verschiedene Tools unterschiedliche Bedürfnisse bedienen
- KI-generierte Ausgaben im A/B-Test auf Qualität prüfen möchten
Das Fazit
Hier gibt es keinen eindeutigen Sieger, und wer etwas anderes behauptet, vereinfacht die Sache zu stark.
GPT-5 ist das vielseitigere Tool — seine multimodalen Fähigkeiten, der Sprachmodus, die Bildgenerierung und das breitere Ökosystem machen es zum Schweizer Taschenmesser unter den KI-Assistenten. Wenn Sie nur eines auswählen könnten, ist es die sicherere Allround-Wahl für die meisten Nutzer.
Claude 4 ist der bessere Denker — es erzeugt qualitativ hochwertigere längere Texte, bewältigt komplexes Denken mit mehr Nuancen, befolgt Anweisungen präziser und verwaltet lange Kontexte zuverlässiger. Für Wissensarbeiter, die viel mit Texten und Dokumenten arbeiten, ist es oft das überlegene tägliche Arbeitswerkzeug.
Die gute Nachricht: Für jeweils 20 USD pro Monat müssen Sie sich nicht entscheiden. Viele Power-User abonnieren beide und nutzen sie je nach anstehender Aufgabe.
Vergleichen Sie andere führende KI-Modelle: ChatGPT vs Gemini 2 | DeepSeek Testbericht | Beste KI-Chatbots 2026
KI-Aktienprognosen — Intelligente Marktanalyse
KI-gestützte Vorhersagen für den Aktienmarkt und technische Analyse. Erhalten Sie tägliche Prognosen für Aktien, ETFs und Kryptowährungen mit Konfidenzwerten und Risikokennzahlen.
Heutige Prognosen ansehenErstellen oder vermarkten Sie ein KI-Tool?
Lassen Sie sich auf AI Tools Hub listen, testen oder vorstellen — 12-monatige gesponserte Einträge, mehrsprachig. Ab $49.
Team von AI Tools Hub
Experten für KI-Tool-Testberichte
Unser Team aus KI-Enthusiasten und Technologieexperten testet und bewertet Hunderte von KI-Tools, um Ihnen zu helfen, die perfekte Lösung für Ihre Bedürfnisse zu finden. Wir bieten ehrliche, tiefgehende Analysen basierend auf der tatsächlichen Nutzung.